
KI lokal betreiben: Was lokale KI im Unternehmen wirklich bedeutet, kostet und kann
„KI lokal“ steht inzwischen auf vielen Angeboten und meint jedes Mal etwas anderes. Drei Ebenen, auf denen KI lokal sein kann, was lokale Modelle heute leisten, was Hardware und Betrieb kosten, und warum der Regelfall im Mittelstand hybrid ist.
Wenn ein Geschäftsführer sagt, er wolle „KI lokal", meint er meistens: Unsere Daten sollen nicht bei einem fremden Anbieter landen. Wenn ein Anbieter „lokale KI" verspricht, meint er oft etwas Engeres: ein Modell, das auf einem bestimmten Rechner läuft, oder eine Software, die in einem Cloud-Mandanten des Kunden installiert wird. Beides ist legitim, aber nicht dasselbe. Wer das nicht auseinanderhält, kauft entweder zu viel Hardware oder zu wenig Datenschutz. Deshalb zuerst die Begriffe, dann die Kosten, dann die ehrliche Antwort, was lokale Modelle heute können.
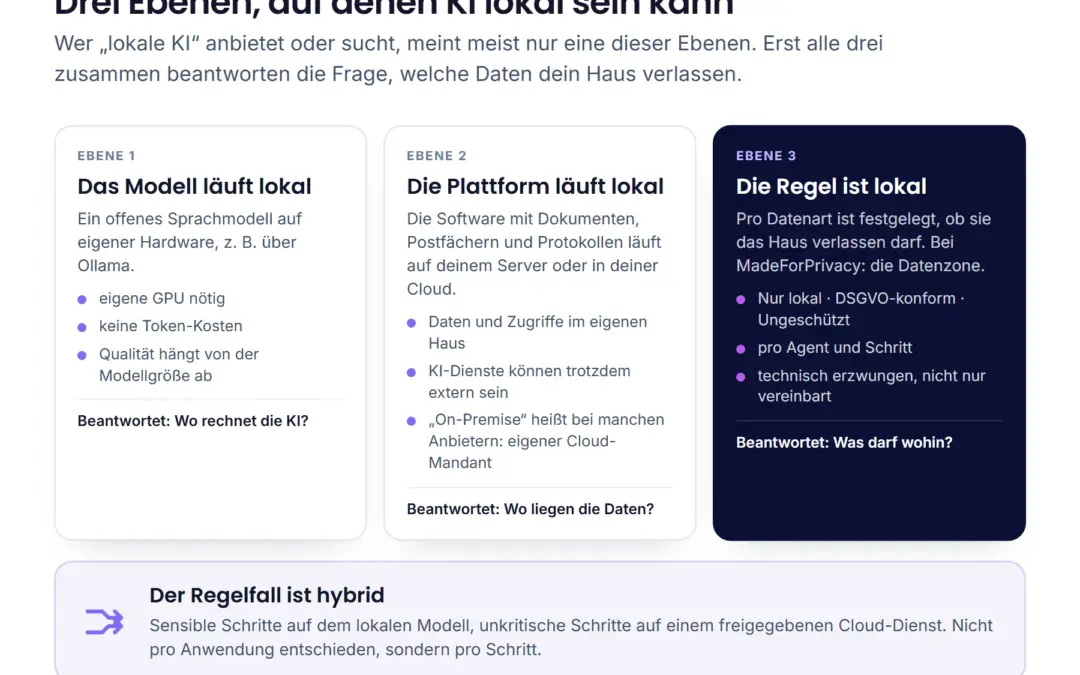
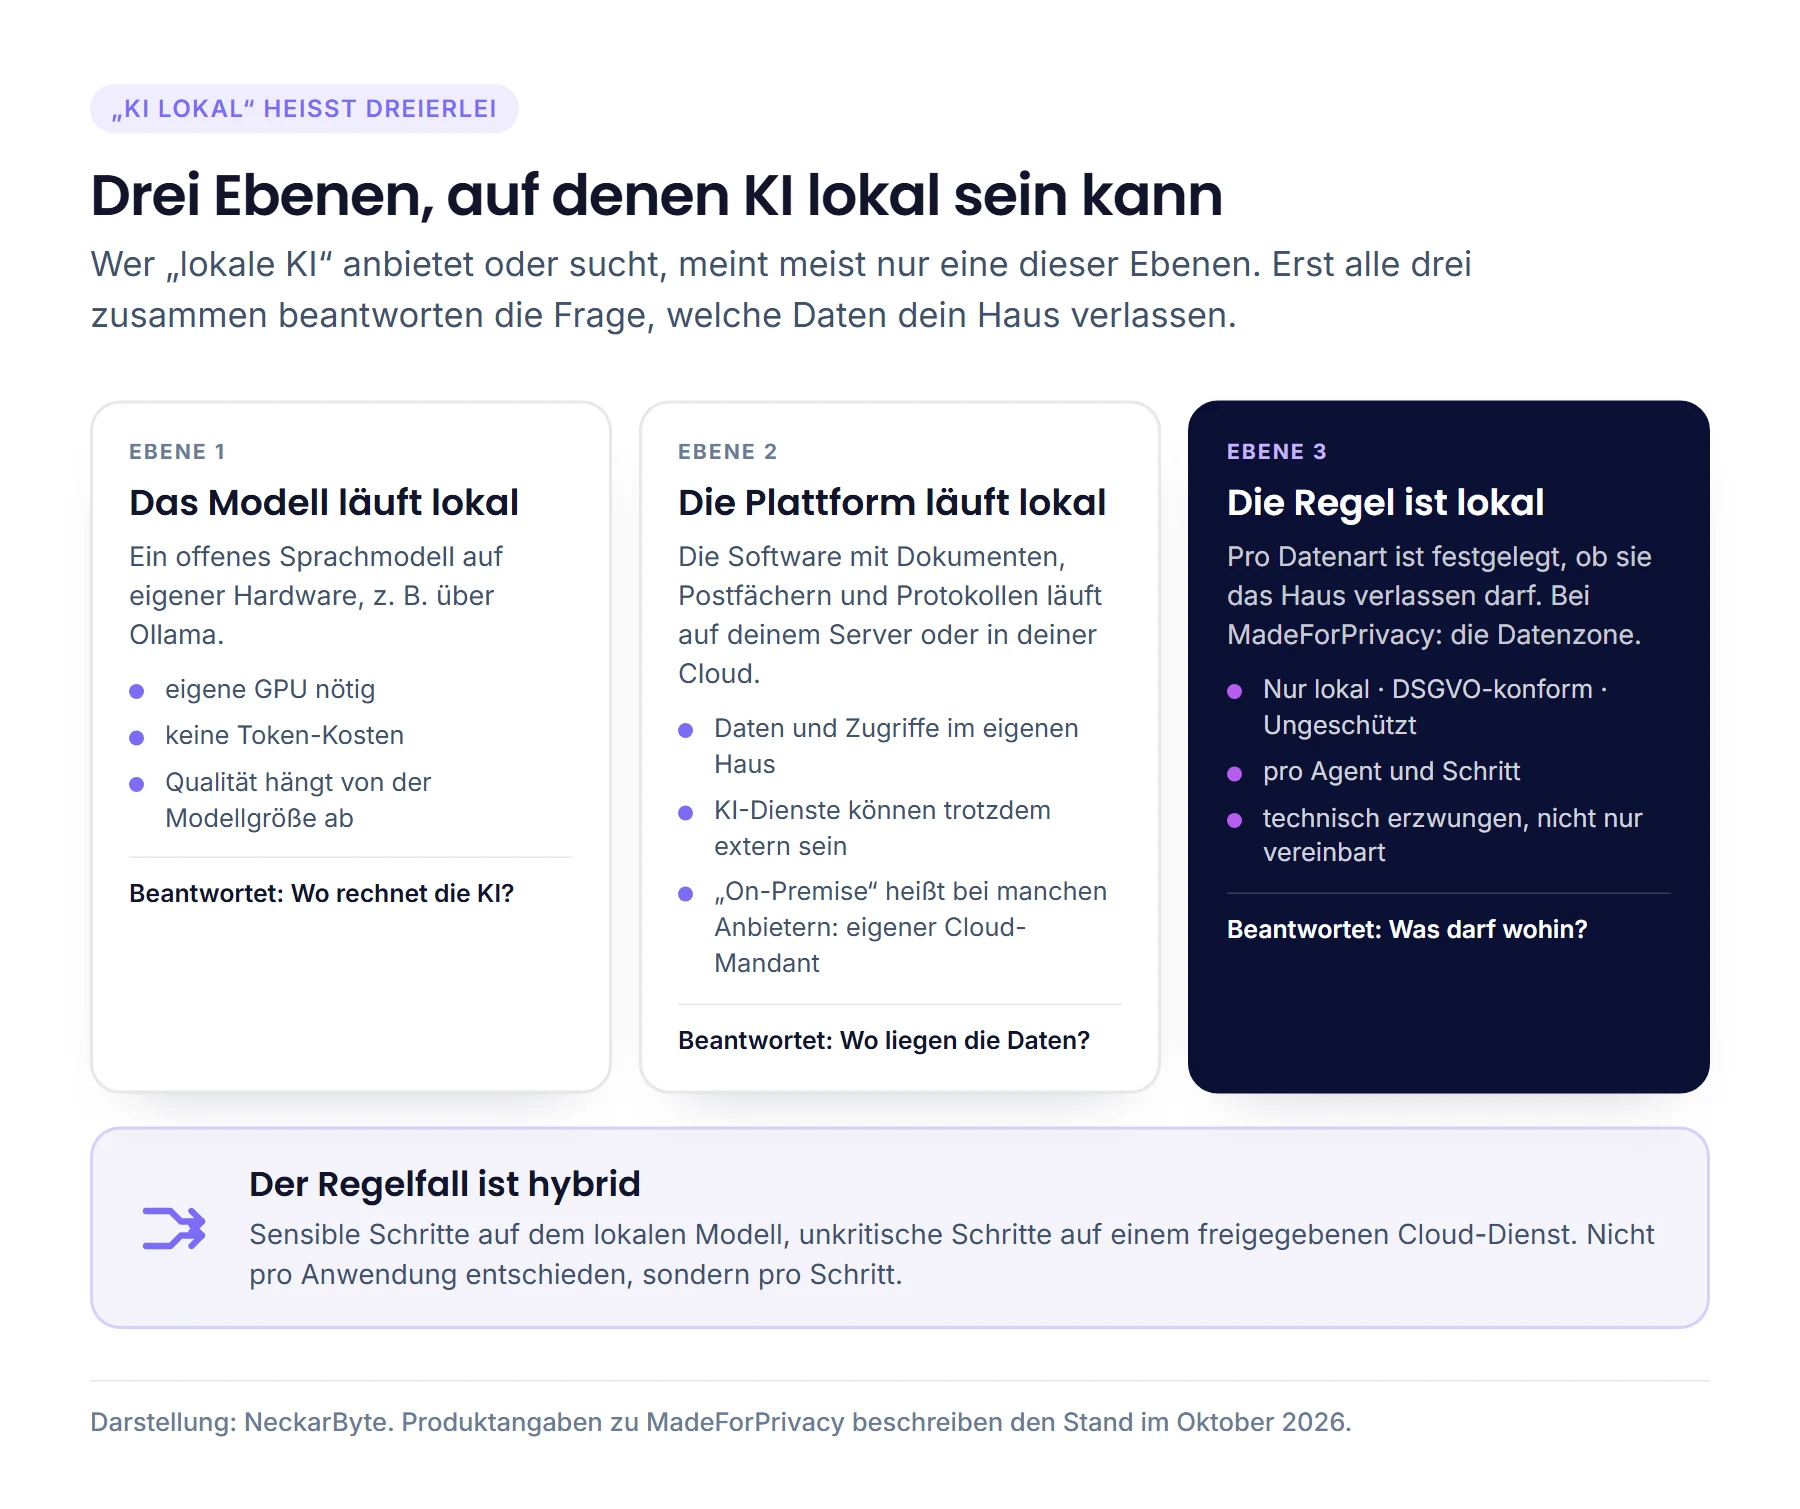
Drei Ebenen, auf denen KI lokal sein kann
Ebene 1: Das Modell läuft lokal
Ein offenes Sprachmodell, etwa aus den Familien Llama, Mistral, Qwen oder Gemma, läuft über eine Laufzeitumgebung wie Ollama auf eigener Hardware.[1] Die Eingaben verlassen den Rechner nicht, es fallen keine Kosten pro Token an, und der Betrieb funktioniert notfalls ohne Internet. Dafür brauchst du eine Grafikkarte mit genug Speicher, und die Qualität der Antworten hängt davon ab, wie groß das Modell ist, das darauf Platz findet.
Ebene 2: Die Plattform läuft lokal
Die Software, die deine Dokumente, Postfächer, Datenbankzugänge und Protokolle verwaltet, läuft auf deinem Server oder in deinem eigenen Cloud-Konto. Das ist die Ebene, die bei den meisten Angeboten mit „On-Premise" gemeint ist. Wichtig ist der zweite Blick: Eine lokal installierte Plattform kann trotzdem jeden KI-Aufruf an einen externen Dienst schicken. Dann liegen die Daten im Haus, die Verarbeitung aber nicht. Manche Anbieter meinen mit „On-Premise" außerdem einen eigenen Mandanten in einer Public Cloud. Das ist eine saubere Lösung, aber kein eigener Server.
Ebene 3: Die Regel ist lokal
Die dritte Ebene wird am seltensten genannt und ist für den Datenschutz die wichtigste: eine Regel, die pro Datenart festlegt, ob sie das Haus verlassen darf. Bei MadeForPrivacy heißt diese Regel Datenzone. Jeder Agent, jedes Werkzeug und jeder KI-Dienst trägt eine der Zonen Nur lokal, DSGVO-konform oder Ungeschützt. Ein Schritt nutzt nur Dienste, die mindestens die Zone seines Agenten erfüllen; passt kein Dienst, läuft der Schritt nicht.[2] Lokal ist damit keine Eigenschaft der Installation, sondern eine Eigenschaft jedes einzelnen Verarbeitungsschritts.
Was lokale Modelle heute können, und was nicht
Die ehrliche Antwort hat zwei Teile. Erstens: Offene Modelle, die auf einer einzelnen Grafikkarte laufen, erledigen eng umrissene Aufgaben gut. Dazu gehören das Einordnen einer eingehenden Mail, das Herausziehen von Rechnungsnummer, Betrag und Lieferant aus einem Beleg, das Zusammenfassen eines Dokuments, das Übersetzen, das Prüfen eines Textes gegen eine feste Liste von Kriterien. Das sind genau die Schritte, aus denen Prozess-Automatisierung im Mittelstand zum größten Teil besteht.
Zweitens: Bei langen, mehrdeutigen Aufgaben, bei denen das Modell über viele Seiten hinweg argumentieren muss, etwa der Prüfung eines umfangreichen Vertrags auf ungewöhnliche Klauseln, sind die großen Modelle der Cloud-Anbieter in der Regel weiterhin besser. Wer behauptet, ein lokales Modell sei „so gut wie" das größte Cloud-Modell, sollte sagen, bei welcher Aufgabe. In unserer Erfahrung ist die richtige Frage deshalb nicht „lokal oder Cloud", sondern „welcher Schritt braucht welches Modell". Ein Agent, der aus zehn Schritten besteht, kann neun davon auf einem kleinen lokalen Modell erledigen und nur für einen das große Modell aufrufen. Die Plattform muss das nur erlauben.
Was es kostet
Ein eigener Server ist nicht automatisch billiger als Token. Vier Posten gehören in die Rechnung.
- Hardware. Entscheidend ist der Grafikspeicher, nicht die Rechenleistung auf dem Papier. Eine Workstation mit einer Grafikkarte der Oberklasse (niedriger bis mittlerer vierstelliger Betrag) trägt Modelle mittlerer Größe für die beschriebenen Standardschritte. Für die großen offenen Modelle braucht es Rechenzentrums-Grafikkarten mit deutlich mehr Speicher, dann liegt der Server im fünfstelligen Bereich. Wer mit kleinen Modellen anfängt, kann oft vorhandene Server nachrüsten.
- Strom und Platz. Eine Grafikkarte unter Last zieht einige hundert Watt. Für einen Agenten, der tagsüber Belege verarbeitet, ist das überschaubar; für einen Dauerbetrieb rund um die Uhr gehört es in die Kalkulation.
- Betrieb. Updates der Modelle und der Plattform, Backups, Monitoring, jemand, der sich kümmert. Das ist der Posten, den die meisten Vergleichsrechnungen weglassen. Ein wartungsarmer Container-Stack mit Grundsupport ändert daran viel, aber nicht alles.
- Token, die nicht anfallen. Dagegen steht, dass lokale Modelle pro Anfrage nichts kosten. Bei MadeForPrivacy rechnest du Token externer Anbieter direkt mit dem Anbieter ab, ohne Aufschlag; lokale Modelle kosten keine Tokens.[2] Ob sich die Hardware rechnet, zeigt deshalb nicht eine Faustformel, sondern dein tatsächliches Volumen. Weil die Plattform jeden Lauf mit Dienst, Tokens und Kosten protokolliert, lässt sich das nach ein paar Wochen Betrieb am echten Prozess ablesen statt schätzen.[3]
Eine Zahl nennen wir bewusst nicht: „Ab X Anfragen pro Tag lohnt sich der eigene Server." Das hängt davon ab, welche Schritte lokal laufen können und wie teuer das Cloud-Modell ist, das du sonst nehmen würdest. Wer dir diese Zahl ohne Blick auf deinen Prozess nennt, rät.
Der Denkfehler: lokal ist nicht automatisch datenschutzkonform
Ein lokales Modell löst ein Problem gründlich: Es gibt keinen Dritten, der die Eingaben sieht, also auch keinen Auftragsverarbeiter, keinen Drittlandtransfer, keine Frage, ob mit deinen Daten trainiert wird. Alles andere bleibt: Zweck und Rechtsgrundlage der Verarbeitung, wer im Haus auf welche Daten zugreifen darf, wie lange Ergebnisse gespeichert werden, wie Betroffene zu ihren Rechten kommen, und die Unterweisung der Beschäftigten. Die Datenschutzkonferenz hat diese Punkte in ihrer Orientierungshilfe zu KI und Datenschutz zusammengestellt, und keiner davon erledigt sich dadurch, dass der Rechner im eigenen Keller steht.[4] Lokal ist eine Voraussetzung, kein Freifahrtschein.
Der Regelfall: hybrid, pro Schritt entschieden
In der Praxis sieht ein gut aufgesetzter Betrieb im Mittelstand so aus: Mitarbeiterdaten, interne Dokumente und Verträge werden in der Zone Nur lokal verarbeitet, mit einem offenen Modell auf eigener Hardware. Kunden- und Auftragsdaten laufen in der Zone DSGVO-konform über Dienste, die dafür freigegeben sind, zum Beispiel einen Cloud-Dienst mit Vertrag und EU-Verarbeitung. Öffentliche Inhalte, etwa Marketingtexte, dürfen in die Zone Ungeschützt. MadeForPrivacy läuft dafür immer self-hosted als Docker-Stack auf deinen Servern oder in deinem eigenen Cloud-Konto; welche KI-Dienste ein Schritt nutzen darf, entscheidet die Datenzone, nicht der Anbieter. Anbindbar sind lokale Modelle über Ollama oder Hugging Face, Azure OpenAI, OpenAI und jeder Dienst mit OpenAI-kompatibler Schnittstelle; auch ein Betrieb komplett ohne Internetverbindung ist möglich.[2]
Der Unterschied zu „wir haben die Cloud-Version und die lokale Version" ist, dass die Entscheidung nicht pro Anwendung fällt, sondern pro Schritt. Das macht den Unterschied zwischen einem Werkzeug, das die IT duldet, und einem, das die IT verantworten kann.
Sechs Fragen, bevor du Hardware bestellst
- Welche Prozesse sollen zuerst laufen, und aus welchen Schritten bestehen sie?
- Welche dieser Schritte verarbeiten Daten, die das Haus nicht verlassen dürfen?
- Reicht für diese Schritte ein Modell mittlerer Größe? Das lässt sich mit echten Belegen in wenigen Tagen testen, bevor jemand einen Server kauft.
- Welches Volumen erwartest du im Monat, und was würden dieselben Schritte bei einem Cloud-Dienst kosten?
- Wer betreibt den Server, und was passiert, wenn er ausfällt?
- Wie setzt die Plattform die Regel „dieser Schritt bleibt lokal" durch: durch Vertrauen, durch Richtlinie oder technisch?
Die sechste Frage ist die, die wir am liebsten hören. Wie MadeForPrivacy sie beantwortet, steht auf der Seite zur Plattform; wie wir die Einführung begleiten, auf unserer Seite zu KI und Beratung.
Quellen
- Ollama: Get up and running with large language models (lokale Laufzeitumgebung für offene Modelle).
- Plattform: Infrastruktur, Datenzonen und häufige Fragen (KI-Dienste, Betrieb ohne Internet, Token-Kosten).
- Datenschutz und Datenzonen: Zonenregel, zonenbasiertes Routing, Protokoll pro Lauf.
- Orientierungshilfe „Künstliche Intelligenz und Datenschutz" (Version 1.0).
Alle Quellen zuletzt abgerufen am 5. Oktober 2026. Hardware-Angaben sind Größenordnungen ohne Preisangabe, weil sich Preise und Modelle schnell ändern. Die Angaben zu MadeForPrivacy beschreiben den Stand der Software im Oktober 2026.
Nächster Schritt
Erst testen, dann kaufen.
Bring einen Prozess und ein paar echte Belege mit. Wir zeigen dir, welche Schritte lokal laufen können, was das kostet und wie die Datenzonen das absichern.
Neueste Kommentare